Object Detection
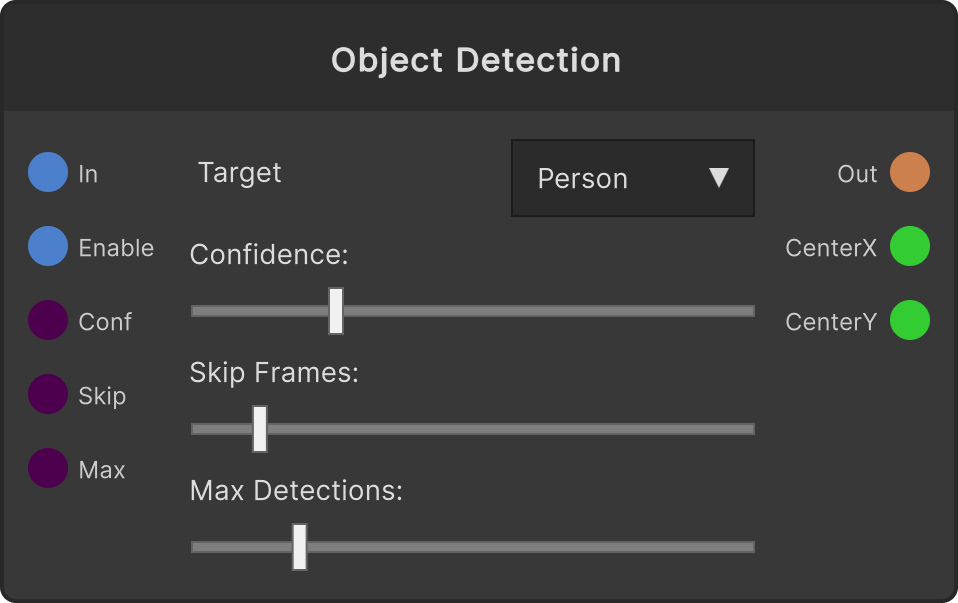
入力映像から物体を検出して、見つかった場所を白い矩形で塗ったマスクを出力します。人・車・動物など、Targetのドロップダウンから選んだ種類の物体を探します。同時に、いちばん確度の高い検出の中心座標(0〜1)も出力するので、検出位置で他のノードを動かすこともできます。
- Target — 検出する物体の種類。初期値はPerson
- Enable — 初期値ON。OFFのときは入力がそのまま素通しします
- Confidence Threshold — この確度を超えた検出だけを採用します。初期値0.25(0〜1)
- Inference Every N Frames — 何フレームに1回検出するか。初期値2(数字を上げるほど軽くなります)
- Max Detections — 描画する検出数の上限。確度の高い順に採用。1〜50、初期値10
- detectedCenterX0 / detectedCenterY0 — 最上位検出の中心(0〜1)。検出が0件のときは両方とも0.5を出力します
マスクは矩形の塗りつぶしです。 物体の形に沿った切り抜きではありません。
同じ物体に複数の枠が重なって出た場合、それらはすべてそのまま描かれます。
検出できるのはTargetで選んだ1種類だけです。複数の種類を同時に扱いたい場合はノードを分けてください。
検出しないフレームでは直前のマスクがそのまま出力されます。入力が未接続のときは黒が出ます。
入力ポート
| Port ID | 型 |
|---|---|
Input Texture | RenderTexture |
Enable | bool |
Confidence Threshold | float |
Inference Every N Frames | int |
Max Detections | int |
出力ポート
| Port ID | 型 |
|---|---|
Mask | RenderTexture |
Boxes | RenderTexture |
CenterX | float |
CenterY | float |
Size | float |
Count | int |
Detected | bool |
Appeared | trigger |
Lost | trigger |
PointCloud | PointCloudOutput |
Blobs | BlobData |
スクリプトから設定可能なメンバー
| パス | 型 |
|---|---|
enableInput | bool |
confidenceInput | float |
skipFramesInput | int |
maxDetectionsInput | int |
isEnabled | bool |
confidenceThreshold | float |
inferenceEveryNFrames | int |
maxDetections | int |
currentMinInterval | float |
Synapse Apps(スクリプティング)
await synapse.modules.create({ type: "YoloDetection" })